Évtizedeken át szabványosított tesztekkel mérték a mesterséges intelligencia fejlődését, és ezek az eredmények gyakran egész kutatási irányzatok sorsát határozták meg. Ma azonban egyre több szakember figyelmeztet arra, hogy az MI-rendszerek képességeit mérő tesztek már nem feltétlenül azt mutatják meg, mennyire intelligensek a modellek, hanem azt, mennyire sikerült felkészíteni őket magukra a vizsgákra. Moritz Hardt, a Max Planck Intézet kutatója szerint a probléma jóval régebbi, mint a ChatGPT megjelenése, és alapjaiban érinti azt, ahogyan a mesterséges intelligencia fejlődését értékeljük. Rövid MI-evolúciós cikk, magyarázatokkal.
A mesterséges intelligencia kutatásában évtizedek óta létezik egy látszólag egyszerű módszer a fejlődés mérésére. A kutatók összeállítanak egy feladatsort, amelyet különböző algoritmusokkal oldatnak meg, majd összehasonlítják az eredményeket. A legjobb teljesítményt nyújtó rendszer kerül a ranglista élére, a fejlesztők pedig újabb és újabb módszerekkel próbálják túlszárnyalni a korábbi rekordokat. Ezeket a szabványosított teszteket nevezik benchmarkoknak, és jelentőségük messze túlmutat a tudományos összehasonlításon: gyakran meghatározzák, milyen kutatások kapnak támogatást, mely technológiákba fektetnek a vállalatok, és milyen irányba fejlődik az egész iparág.
A rendszer ésszerűnek tűnik, hiszen a tudományban alapvető követelmény, hogy az eredményeket objektív, megismételhető módszerekkel lehessen ellenőrizni. A probléma akkor kezdődik, amikor a mérés eredménye fontosabbá válik annál a képességnél, amelyet eredetileg mérni akartak. Ha egy algoritmust kizárólag arra fejlesztenek, hogy egy adott teszten minél magasabb pontszámot érjen el, akkor idővel olyan megoldások is előnybe kerülhetnek, amelyek a valóságban nem jelentenek ugyanekkora előrelépést.
Ez nagyjából ahhoz hasonlítható, mint amikor egy diák nem a tananyagot próbálja megérteni, hanem több ezer korábbi vizsgakérdés megoldását tanulja meg. A vizsgán kiváló eredményt érhet el, de ha egy ismeretlen problémával találkozik, könnyen kiderülhet, hogy tudása sokkal korlátozottabb, mint amit a bizonyítványa sugall.
A tesztek, amelyek megváltoztatták a mesterséges intelligencia történetét
A benchmarkok jelentőségét jól mutatja, hogy a mesterséges intelligencia történetének több fordulópontja is szorosan kapcsolódott egy-egy ilyen méréshez. Az 1980-as évek végén az amerikai DARPA beszédfelismerési értékelései rámutattak arra, hogy a korábban nagy reményekkel fejlesztett, szabályokra és szakértői tudásra épülő rendszerekkel szemben az egyszerűbbnek tekintett statisztikai módszerek rendkívül versenyképesek lehetnek. Az eredmények hozzájárultak a kutatási prioritások átrendeződéséhez, és egy olyan korszakban születtek, amikor a mesterséges intelligenciával kapcsolatos túlzott várakozásokat egyre erősebb kiábrándulás követte. Az úgynevezett „MI-lehülés” (MI-érdektelenség a megfelelő szó rá) idején a finanszírozás több területen visszaesett, a kutatók pedig kénytelenek voltak újragondolni, milyen módszerekkel lehet valódi előrelépést elérni. A visszaesésnek természetesen számos gazdasági és technológiai oka volt, nem vezethető vissza egyetlen teszt eredményére.
A következő nagy fordulat 2012-ben következett be, amikor az ImageNet nevű képfelismerési versenyen egy AlexNet néven ismert, nyolc tanult rétegből álló neurális hálózat látványosan felülmúlta a korábbi megoldásokat. A rendszer képes volt hatalmas képadatbázis alapján megtanulni a különböző tárgyak és élőlények vizuális jellegzetességeit, anélkül hogy a programozóknak minden felismerési szabályt külön meg kellett volna határozniuk.
Az eredmény a mélytanulás forradalmának egyik meghatározó pillanatává vált. A neurális hálózatok kutatása új lendületet kapott, a számítási kapacitások növekedése pedig lehetővé tette egyre nagyobb és összetettebb modellek fejlesztését. Az ImageNet sikere nem pusztán egy verseny megnyerését jelentette, hanem olyan technológiai irányt jelölt ki, amely később a modern generatív mesterséges intelligencia fejlődéséhez is hozzájárult.
Moritz Hardt szerint azonban éppen ez a történet rejti a benchmarkok egyik legnagyobb ellentmondását. A szabványosított tesztek valóban segítettek megtalálni a hatékonyabb algoritmusokat, de ebből még nem következik, hogy maguk a tesztek tudományosan megfelelően mérték volna az intelligenciát. Elképzelhető, hogy a módszer sokáig azért működött, mert a teszteredmények javítása és a valóban hasznos technológiai fejlődés szerencsés módon ugyanabba az irányba mutatott.
Amikor a ranglista fontosabbá válik a tudásnál
A mai nagy nyelvi modellek megjelenésével a benchmarkok szerepe még hangsúlyosabbá vált. A fejlesztőcégek rendszeresen teszik közzé legújabb modelljeik teljesítményét matematikai, programozási, természettudományos, logikai és általános ismereti feladatsorokon. Egyes tesztek egyetemi vizsgákhoz hasonló kérdéseket tartalmaznak, mások bonyolult programozási problémákat, megint mások azt próbálják meghatározni, hogy egy modell mennyire képes emberi szintű gondolkodást igénylő feladatokat megoldani.
Csakhogy az eredmények értelmezése egyre nehezebbé válik. A modern nyelvi modelleket az interneten elérhető hatalmas szövegmennyiségeken tanítják, amelyek között tudományos publikációk, tankönyvek, programkódok és korábbi tesztfeladatok is szerepelhetnek. Emiatt nem mindig állapítható meg egyértelműen, hogy egy rendszer valóban képes-e önállóan megoldani egy problémát, vagy a tanítása során már találkozott annak valamelyik változatával.
A helyzetet tovább bonyolítja, hogy a fejlesztők pontosan ismerik a legfontosabb teszteket, és gyakran ezek eredményei alapján módosítják modelljeiket. Egy algoritmus teljesítménye így nemcsak azért javulhat, mert általánosan jobb problémamegoldóvá vált, hanem azért is, mert fejlesztése során különös figyelmet fordítottak a ranglistákon szereplő feladatokra.
Ezt a jelenséget nevezik informálisan benchmaxxingnak, vagyis a benchmarkeredmények maximalizálásának. A kifejezés arra utal, hogy a kutatási és fejlesztési folyamat célja fokozatosan eltolódhat a valódi képességek fejlesztésétől a mérőszámok optimalizálása felé.
A probléma nem kizárólag a mesterséges intelligenciára jellemző. A közgazdaságtanban és a társadalomtudományokban régóta ismert az a jelenség, amelyet gyakran Goodhart törvényével foglalnak össze: ha egy mérőszám céllá válik, könnyen elveszítheti eredeti mérési értékét. Egy iskola például javíthatja a vizsgaeredményeket anélkül, hogy a diákok valódi tudása ugyanilyen mértékben fejlődne, ha a tanítás kizárólag a várható vizsgakérdésekre összpontosít.
Ugyanez történhet a mesterséges intelligenciával is. Egy modell képes lehet rendkívül magas pontszámot elérni egy matematikai teszten, miközben egy kissé szokatlanul megfogalmazott, de alapvetően egyszerű feladatban hibázik. Egy másik rendszer sikeresen teljesíthet programozási feladatokat ellenőrzött környezetben, de egy valódi szoftverfejlesztési projekt során, ahol hiányos dokumentációval, váratlan hibákkal és egymásnak ellentmondó követelményekkel találkozik, már lényegesen gyengébben működhet.
Miért működtek mégis évtizedeken át?
Hardt új, The Emerging Science of Machine Learning Benchmarks című könyvében egy különösen érdekes megfigyelésre hívja fel a figyelmet. Bár a benchmarkok abszolút pontszámai gyakran félrevezetők voltak, a különböző modellek egymáshoz viszonyított sorrendje sokáig meglepően megbízhatónak bizonyult.
Ha például egy algoritmus egy képfelismerési teszten 90 százalékos pontosságot ért el, egy másik pedig csak 80 százalékot, ebből nem lehetett pontosan megállapítani, hogyan teljesítenek majd a valós világban. Egy másik képadatbázison ugyanis mindkét rendszer lényegesen eltérő eredményt produkálhatott. A tapasztalatok szerint azonban a jobbik modell rendszerint az új adatokon is jobb maradt, vagyis a rangsor akkor is megőrizte érvényességét, amikor a konkrét százalékos eredmények megváltoztak.
Ez magyarázhatja, hogy a gépi tanulás miért tudott évtizedeken keresztül valódi fejlődést elérni olyan mérési módszerekkel, amelyek tudományos szempontból korántsem voltak tökéletesek. A kutatóknak nem feltétlenül kellett pontosan tudniuk, mit jelent egy adott pontszám, elegendő volt, ha a jobb eredmény általában valóban jobb algoritmust jelzett.
A nagy nyelvi modellek azonban megváltoztatták ezt a helyzetet. A korábbi gépi tanulási versenyeken a résztvevők gyakran ugyanabból a tanítóadatbázisból indultak ki, ezért a különböző algoritmusok teljesítménye viszonylag tisztességesen összehasonlítható volt. A mai nyelvi modelleknél ezzel szemben a tanításra használt adatok összetétele többnyire nem nyilvános, és jelentős különbségek lehetnek abban is, hogy a fejlesztők milyen feladatokra készítették fel őket.
Így könnyen előfordulhat, hogy egy általánosan gyengébb modell megelőz egy erősebbet egy adott ranglistán, pusztán azért, mert sokkal alaposabban felkészítették az adott tesztre. Hardt szerint ezzel a benchmarkok elveszíthetik azt a tulajdonságukat, amely korábban a hiányosságaik ellenére is hasznossá tette őket: a rangsorok megbízhatóságát.
Hogyan lehetne igazságosabban mérni a mesterséges intelligenciát?
Hardt nem azt javasolja, hogy hagyjunk fel a benchmarkok használatával. Ehelyett olyan értékelési módszert képzel el, amely figyelembe veszi, hogy a modern modellek már eleve különböző felkészültséggel érkeznek a vizsgára.
Ennek szemléltetésére egy sporttörténeti példát használ. Az 1968-as mexikóvárosi olimpián a nagy tengerszint feletti magasság különleges kihívást jelentett az atléták számára, mivel a ritkább levegő befolyásolta az állóképességi teljesítményt. A magashegységi környezetben edződött sportolók bizonyos előnyökkel rendelkezhettek azokkal szemben, akik ilyen körülményekhez nem szoktak hozzá.
A megoldás végül nem az lett, hogy megtiltották a magaslati edzést, hanem az, hogy ez a felkészülési módszer széles körben elfogadottá vált.
Hardt szerint valami hasonlóra lenne szükség a mesterséges intelligencia tesztelésében is. A különböző modelleknek a végső értékelés előtt szabványosított, az adott feladattípushoz kapcsolódó felkészítést lehetne biztosítani. Ezzel csökkenthető lenne az az előny, amelyet egyes rendszerek pusztán azért élveznek, mert fejlesztőik korábban nagyobb hangsúlyt fektettek egy bizonyos benchmarkra.
Ez természetesen nem oldaná meg a mesterséges intelligencia mérésének minden problémáját. A felkészítésre adott válasz modellfüggő lehet, a különböző rendszerek tanítási előzményei továbbra sem feltétlenül ismerhetők meg, és a valós feladatok összetettségét sem lehet néhány szabványosított vizsgával tökéletesen visszaadni. Az elképzelés mégis fontos szemléletváltást jelentene: a tesztek többé nem egyszerűen a kész modellek versenyeztetéséről szólnának, hanem magának az összehasonlítási módszernek a tudományos megalapozásáról is.
A legfontosabb kérdésre a benchmarkok nem adnak választ
A vita végső soron túlmutat azon, hogy melyik mesterséges intelligencia hány százalékot ér el egy matematikai vagy programozási feladatsoron. A tudomány egyik alapvető célja ugyanis nem csupán a jelenségek előrejelzése, hanem a mögöttük álló mechanizmusok megértése.
A modern neurális hálózatok esetében a kutatók részletesen ismerik a rendszerek matematikai felépítését és tanítási eljárásait, de még mindig csak részben értik, hogyan alakulnak ki bennük az összetett képességek, és miért viselkednek bizonyos helyzetekben váratlanul. Egy benchmark megmutathatja, hogy egy modell sikeresen megoldott egy problémát, de önmagában nem árulja el, milyen belső folyamatok vezettek az eredményhez, vagy hogy a rendszer mennyire megbízható egy korábban nem látott helyzetben.
Ez különösen fontossá válik, ahogy a mesterséges intelligencia egyre nagyobb szerepet kap a tudományos kutatásban, az orvostudományban, a mérnöki tervezésben és a mindennapi döntéshozatalban. Egy olyan rendszer esetében, amely csupán képeket osztályoz, a néhány százalékos teljesítménykülönbség is értékes információ lehet. Egy orvosi diagnózist támogató vagy kritikus infrastruktúrát felügyelő modellnél azonban az is számít, milyen hibákat követ el, felismeri-e saját bizonytalanságát, és hogyan reagál a megszokottól eltérő körülményekre.
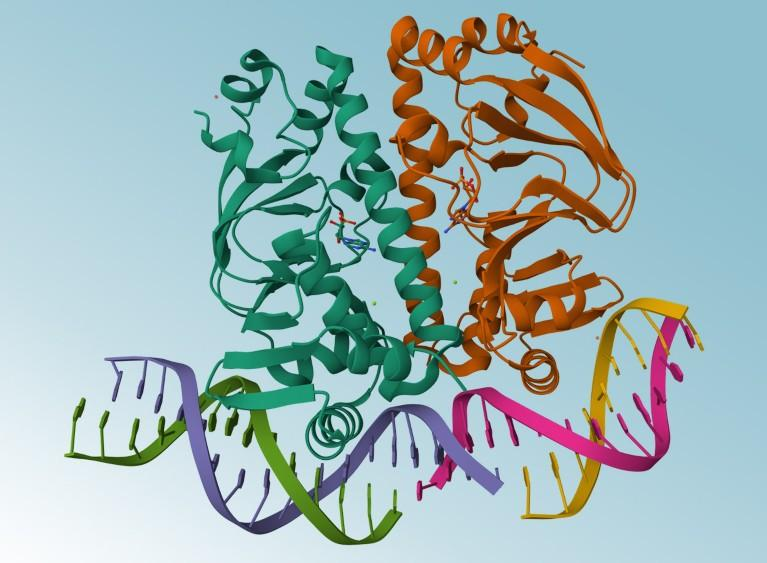
Hardt ugyanakkor arra is emlékeztet, hogy a szabványosított versenyek a tudomány más területein is képesek voltak jelentős fejlődést előidézni. Jó példa erre a fehérjék térszerkezetének előrejelzésére létrehozott CASP verseny, amely hozzájárult az olyan rendszerek fejlődéséhez, mint az AlphaFold (Az AlphaFold a Google DeepMind által kifejlesztett mesterséges intelligencia, amely képes megjósolni a fehérjék háromdimenziós szerkezetét az őket felépítő aminosavak sorrendje alapján. Segítségével a kutatók olyan molekuláris szerkezeteket is megismerhetnek, amelyek meghatározása korábban hónapokig vagy évekig tarthatott, jelentősen felgyorsítva a biológiai és gyógyszerkutatásokat. Az AlphaFold fejlesztéséért Demis Hassabis és John Jumper 2024-ben kémiai Nobel-díjat kapott). A kutatóknak nem kellett előzetesen teljesen megérteniük a fehérjék feltekeredésének minden részletét ahhoz, hogy a pontosabb előrejelzések révén fontos tudományos eredmények szülessenek.
A benchmarkok tehát továbbra is értékes eszközök lehetnek, de csak akkor, ha világosan meghatározzuk, mit mérnek, és milyen következtetéseket lehet levonni az eredményeikből.
A mesterséges intelligencia fejlődését ma gyakran újabb rekordokkal, egyre magasabb pontszámokkal és látványos ranglistákkal szemléltetik. Ezek mögött kétségtelenül jelentős technológiai előrelépés áll, de a számok önmagukban nem bizonyítják, hogy a rendszerek általános intelligenciája ugyanilyen ütemben növekszik.
A következő évek egyik legfontosabb kutatási feladata ezért nemcsak az lehet, hogy intelligensebb gépeket építsünk, hanem az is, hogy megtanuljuk megbízhatóbban megkülönböztetni a valódi képességeket a tesztekre való sikeres felkészüléstől. Mert amíg nem értjük pontosan, mit mérünk, addig azt sem tudhatjuk biztosan, mekkora fejlődést jelentenek az újabb rekordok.
Forrás: John Pavlus, Quanta Magazine, 2026. október 16. – He Wants AI Benchmarking To Be a Science, Not a Dark Art; Moritz Hardt: The Emerging Science of Machine Learning Benchmarks.